
Новости HuggingFace
Хаб моделей и датасетов, библиотеки transformers/diffusers, ежедневная подборка статей.
60 материал(ов) · последние обновления
Nemotron 3 взял двойное золото на олимпиадах по кодингу и математике
Одна модель адаптируется к сложнейшим задачам программирования и математики — по универсальному рецепту.
Falcon-Emirati-7B: LLM Hugging Face улавливает эмиратский диалект и его культурную суть
Модель построена на гибридной архитектуре Falcon-H1 и нацелена на тонкости языка, которые не видят общие LLM.
Microsoft ThinkingBox: агентов проверят по следам в базе, а не по ответам
Новый бенчмарк оценивает реальное влияние ИИ-агентов на бэкенд, а не только их диалоги.
AI2 Olmo-core 3: ускоряет обучение триллионных MoE-моделей в 2.7 раза
Открытая архитектура MoE снижает затраты на разработку гигантских LLM и делает их доступнее.
AI2 выпустила Olmo-core 3: обучает триллион-параметровые MoE-модели в 2.7 раза быстрее
Открытая инфраструктура для гигантских моделей на миллиарды экспертов, которая снижает затраты и сложность обучения.
Hugging Face: Open TTS Leaderboard оценит тысячи моделей за часы, а не недели
Новый бенчмарк фокусируется на многоязычности и клонировании голоса, дополняя, но не заменяя человеческую оценку.
ProvenanceGuard: ИИ-агенты Hugging Face больше не припишут факт неверному источнику
Для критических систем важно не только, что сказано, но и откуда — это снижает риски в медицине и финансах.
Holo4 от HuggingFace: один ИИ-агент для всех экранов и API
Модель кликает, пишет код и вызывает сервисы — и обходится дешевле конкурентов.
Hugging Face Hub 2.0: готовьтесь переписывать код — сменился HTTP-клиент
Библиотека перешла на httpx2 из-за прекращения поддержки старого клиента, удалив при этом ряд устаревших API.
NVIDIA Nemotron 3 Diarization: рекорд для 8 голосов, даже перекрывающихся
Открытая модель со 100 млн параметров — #1 на VoiceArena с 14.72% ошибкой.
Hugging Face наняла создателя oMLX — и упростит ИИ на Apple Silicon
Теперь переносить модели из Transformers в MLX станет проще, а oMLX получит полноценную поддержку.
Hugging Face сжимает LLM вдвое и улучшает MMLU на 23% — с помощью физики
Обычные методы не учитывают, как блоки LLM влияют друг на друга — новый подход это исправляет, используя оптимизацию Изинга.
IBM ALTK-Evolve: ИИ-агенты теперь стабильны — сбоев на повторах стало вдвое меньше
Инструмент с открытым кодом учит агентов повторять успех стабильно, а не просто быть «точными в среднем».
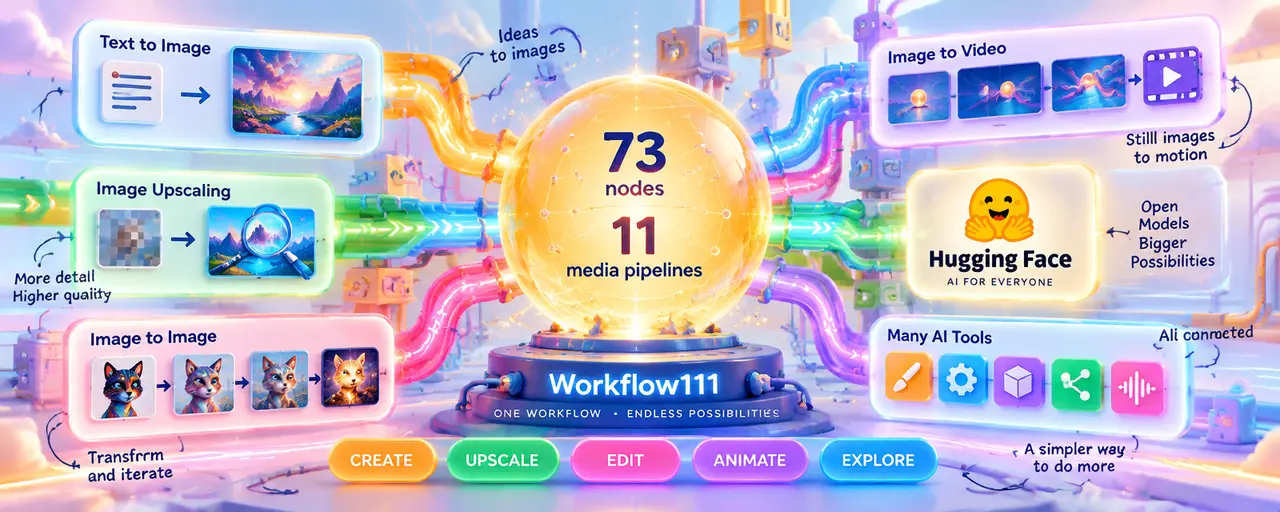
Workflow1111: Hugging Face превратил AUTOMATIC1111 в визуальный конструктор
Все функции AUTOMATIC1111 в 73 узлах одного графа — от генерации до редактирования и видео.
IBM Granite PatchTST-FM-r2: самый точный прогноз временных рядов — теперь с открытой лицензией
Модель на 385 млн параметров не требует дообучения под каждый набор данных — и доступна с открытой лицензией.
HuggingFace: ИИ научится отказывать точнее — не от темы, а от её вредной части
Текущие методы безопасности блокируют целые темы; новый подход учит модель находить тонкую грань между вредным и безобидным.
IBM и Confluent: большие модели для потоков данных — прогностика без экспертов
Каждая точка точности таких моделей стоит миллионы, а настроить их может не дата-сайентист, а любой инженер.
IBM TSFM на Confluent Cloud: умная аналитика потоков — теперь без дата-сайентистов
Обученные на огромных данных, эти модели обобщают поведение потоков, заменяя месяцы ручной работы экспертов.
Hugging Face выпустила 207 WebGPU ядер для ИИ в браузере — и просит сообщество помочь их улучшить
Переносимость WebGPU не гарантирует скорости; теперь сообщество будет искать оптимальные настройки прямо на железе пользователей.
Hugging Face научила ASR-бенчмарки искать предвзятость — и добавила хинди
Обычные метрики ASR скрывают, как модели ошибаются для разных людей. Новые наборы данных учитывают 9 параметров, чтобы это исправить.
Hugging Face Hub v1.29.0: Xet-загрузки ускорились — и закрыли опасности pickle
Видимость хранилищ теперь можно менять после создания, а защита от вредоносных бакетов усилена.
Hugging Face Transformers: GLM-5.3-Flash удешевляет длинный контекст в 10 раз
Новые гибридные архитектуры сочетают разреженное и линейное внимание, приближаясь к Claude Opus в сложных задачах.
`gr.Workflow` в Gradio: отлаживайте AI-пайплайны как граф — и сразу получайте API
Пайплайн становится интерфейсом: видны все промежуточные результаты, а каждый шаг можно запустить отдельно.
Hugging Face: ASR-модели подстраиваются под бенчмарки, а не под речь
Высокие баллы не означают, что модель лучше слышит: она может просто воспроизводить ошибки бенчмарков.

LFM2.5 с DSpark: до 3.2х быстрее — и без потерь
DSpark ускоряет инференс втрое, сохраняя качество — это критично для локальных агентов.

Hugging Face: Память для ИИ-агентов нужно дозировать, а не копить
Сильным моделям нужна полная база знаний, слабым — выборочная, а насыщенным — ничего.

Sentence Transformers 6.0: поиск по каждому слову — и находит точнее
Один вектор на каждое слово текста — это сильно повышает точность поиска, но увеличивает индекс.

Dharma AI: +33% к утилизации GPU — с тем же железом
Неэффективное распределение простаивает дорогое железо — и это следующая большая проблема в корпоративном AI.

Открытые модели AI теперь движут производители чипов: AMD и NVIDIA обходят Meta
Hugging Face отмечает, что свободные модели стали инструментом для продажи железа, а не только для исследований.

Hugging Face: роботы учатся на данных — без лишних гигабайт
Дедупликация на байтовом уровне и потоковая передача данных сокращают затраты на постоянно растущие датасеты.

LFM2.5-VL-3B видит экраны и кликает по ним — работает на вашем железе
Модель отвечает прямо, не рассуждая, для работы на устройстве — и конкурирует с более крупными аналогами.

ALTK-Evolve учит AI-агентов на опыте — без лишних токенов
Система учит агентов принципам, а не пересказу прошлых действий, что делает их надёжнее в сложных задачах.

Сжать LLM стало вдвое дешевле: хватит одной GPU
Учитель больше не сидит в памяти вместе с учеником, сокращая пиковое потребление VRAM со 250 до 128 ГБ.

Hugging Face выпустила TutorMoments: как оценить, когда ИИ-репетитору пора замолчать
Фреймворк на реальных уроках выявил, что модели мешают студентам пройти «продуктивную борьбу» — и не дают им учиться самостоятельно.

Baseten на Hugging Face Hub: LLM теперь запускаются прямо со страницы модели
Это третий провайдер инференса на Hub, позволяющий инженерам запускать LLM без сложной настройки.

LFM2.5-2.6B: сложные агенты теперь на телефоне — и без облака
Модель на 2.6B параметров обходит конкурентов вчетверо больше себя, умещаясь в 2.5 ГБ памяти.

Hugging Face: главный тормоз AI — не интеллект, а утилизация GPU
Как и самолёты, GPU стоят постоянно, но приносят доход только в работе — это меняет фокус инфраструктуры.

LFM2.5-Encoders от LiquidAI: 8192 токена контекста — быстрее крупных и на CPU
Модели не уступают по качеству более крупным конкурентам — и снижают затраты на развертывание.

NVIDIA Cosmos-H-Dreams: хирургические роботы учатся в реальном времени
Роботы учатся без риска и быстрее, чем на реальных операциях.

Nunchaku Lite в Diffusers: 4-битные модели стали вдвое легче
Веса и активации квантуются до 4 бит, чтобы модели работали быстрее, а не только занимали меньше памяти.

Hugging Face Grabette: учи роботов, записывая рукой — без робота
Главное узкое место в обучении роботов — данные, а не модели.

NVIDIA Cosmos 3 Edge: роботы понимают мир и действуют — прямо на устройстве
Открытая модель мира в 4 млрд параметров позволяет роботам рассуждать в реальном времени и управлять собой.

Hugging Face и NVIDIA: масштабируйте дообучение Diffusers-моделей без переделок
Распределённое обучение на сотнях GPU теперь сводится к одной настройке — без конвертации и изменения кода.

Hugging Face отбила атаку ИИ-агентов — своим же ИИ
Это первое вторжение автономных ИИ-агентов, подтвердившее прогнозы отрасли, — и защита тоже была на ИИ.

Hugging Face Real World VoiceEQ: ИИ научат слушать, а не только говорить
Бенчмарк оценивает, как естественно голосовые модели распознают эмоции и контекст — то, что игнорировали прошлые тесты.
Hugging Face: профайлер покажет, где тормозит Attention
Третья часть серии «Профилирование в PyTorch» учит видеть эффект разных оптимизаций механизма внимания на уровне GPU-кернелов.
Hugging Face Hub: Spaces из шаблонов — AI-приложения за минуты
Теперь не нужно настраивать инфраструктуру для демок — и инструменты CLI обновляются сами.
`transformers` от Hugging Face теперь работает как vLLM — без своих портов
Теперь модели не нужно портировать дважды — достаточно одной интеграции в transformers.

LeRobot v0.6.0: роботы представляют будущее — и это их не замедлит
Модели мира предсказывают действия наперёд во время обучения, но при выполнении задачи исчезают, не увеличивая задержку.

Diffusers 0.39.0: 11 новых моделей — от физического ИИ до видео на телефоне
Библиотека Hugging Face получила 11 готовых конвейеров для генерации и редактирования видео и изображений — включая адаптивные и работающие на устройстве.

Gemma 4 отвечает мгновенно: Hugging Face и Cerebras ускорили живой диалог
Модульная архитектура на специализированном железе убирает задержки в разговоре с ИИ.
Hugging Face собрал оценки AI-моделей в одном месте — и сделал их надёжнее
Тысячи бенчмарков из разных источников теперь в едином формате — с фильтром по железу.

DiScoFormer: одна модель для плотности и скоринга — без переобучения
Трансформер оценивает плотность и скоринг данных за один проход, обходя проблему переобучения и неточности классических методов.
Hugging Face: LLM-сервер одной командой — как OpenAI API, без Kubernetes
Приватный эндпоинт на GPU, оплата посекундная — для тестов и разработки.
Olmo Hybrid: вдвое меньше данных для той же мощности — и предсказывает иначе
Гибридные модели лучше улавливают контекст, а трансформеры точнее цитируют — это меняет подход к выбору архитектур.
NeMo AutoModel от Hugging Face и NVIDIA: MoE-модели обучаются в 3.7 раза быстрее — без смены кода
Библиотека сокращает расход памяти GPU на 32% — это упрощает работу с MoE-моделями.

huggingface_hub выходит каждую неделю — без закрытых API и платных платформ
Весь стек скопируем: GitHub Actions, open-weights GLM-5.2 и HF Inference Providers — ничего проприетарного.
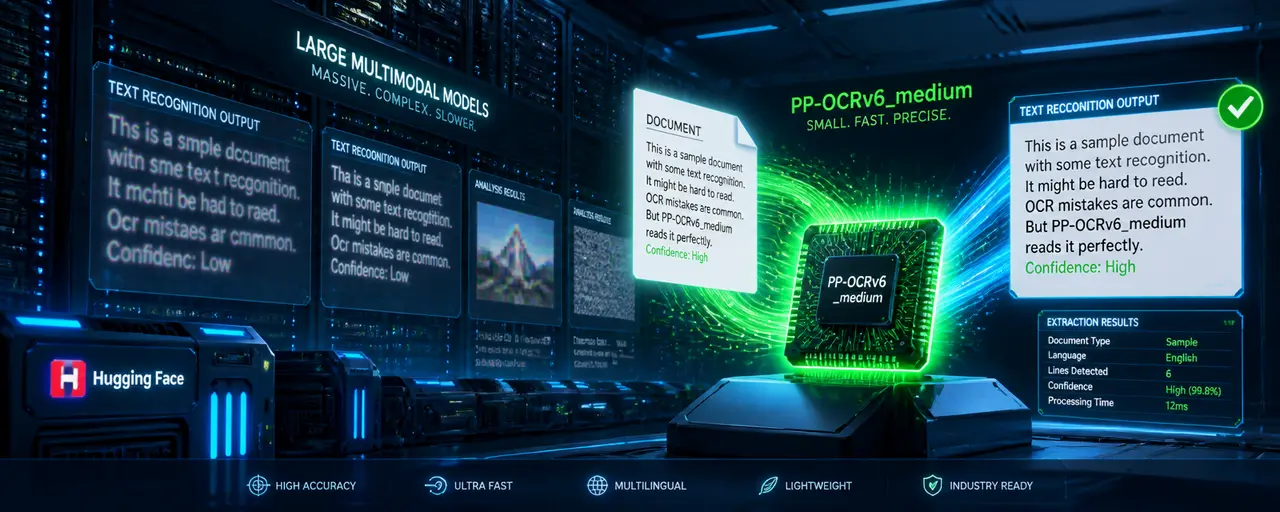
PP-OCRv6 на 34,5M параметрах обогнала GPT-5.5 и Qwen3-VL-235B в распознавании текста
Специализированная OCR в тысячи раз компактнее флагманских мультимодальных моделей — и точнее на их же задаче.

Исследовательский агент сливает корпоративные секреты через поисковые запросы — даже когда его просят молчать
PA-DR снижает утечки с 34% до 9,9%, одновременно повышая точность ответов с 48,7% до 58,7%.

98% PEFT-моделей используют LoRA — Hugging Face предлагает это оспорить
При правильно подобранных гиперпараметрах альтернативы дают тот же результат — а значит, монополия LoRA держится на инерции, не на качестве.