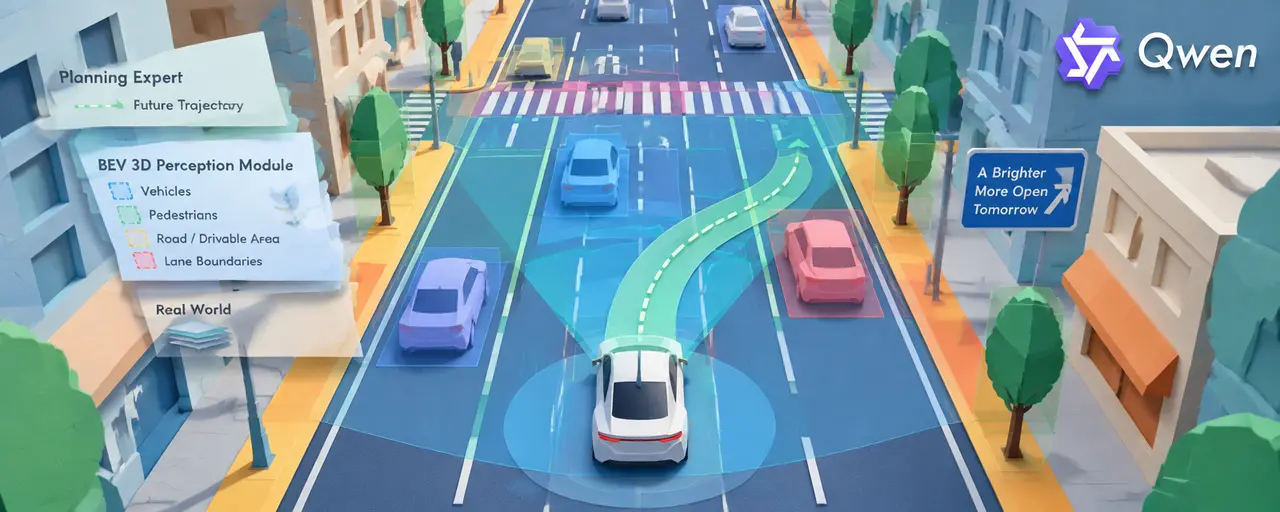
Когда речь заходит о системах автономного вождения, многие разработчики, как и Tesla, стремятся к полному сквозному обучению, где все компоненты интегрированы в одну нейросеть. Alibaba представила Qwen-Drive-1.0, показав альтернативный подход: адаптацию универсальной языковой модели зрения (VLM) для критически важных задач автономного вождения, добавляя специализированные внешние модули без изменения её ядра.
Qwen-Drive-1.0 — это первая унифицированная фундаментальная модель зрения-языка (VLM), предназначенная для автономного вождения. Она объединяет в себе три ключевые функции: 3D-восприятие окружающего мира, ответы на визуальные вопросы и планирование движения. Модель построена на базе уже существующей мультимодальной Qwen3.5-4B, при этом её основная архитектура осталась полностью нетронутой.
Для автономного вождения к базовой VLM добавили два внешних модуля:
- BEV-модуль восприятия (Bird's-Eye-View, вид сверху) — это явный, проверяемый 3D-инструмент. Он одновременно выполняет 3D-обнаружение объектов, семантическое предсказание занятости пространства и сегментацию карты в проекции «сверху». Этот модуль даёт чёткие результаты восприятия, сохраняя при этом высокую производительность базовой VLM в задачах зрения-языка.
- Эксперт по планированию — генерирует будущие траектории движения автомобиля на 5 секунд вперёд, используя технику сопоставления потоков (flow matching). Он также может учитывать текстовые указания для планирования.
Обучение модели проходило в несколько этапов, используя специальный подход к данным. Он объединяет метки из разных наборов данных, переписывает ответы и отфильтровывает образцы для согласованности. Такой метод позволяет совмещать данные для вождения с общими задачами VLM, адаптируясь к новой области и снижая риск «катастрофического забывания» ранее полученных знаний.
В тестах Qwen-Drive-1.0 показала средний результат 69.43 в задачах вопросов-ответов по сценариям вождения, превзойдя как универсальные VLM, так и специализированные модели для вождения. В задачах планирования движения модель также продемонстрировала высокую производительность в сценариях как с разомкнутым, так и с замкнутым циклом. Для обучения использовались только общедоступные данные, общим объёмом 2.83 миллиона образцов, с унифицированным форматом траекторий для стабильного прогнозирования на скорости 10 Гц.
Подход Alibaba с Qwen-Drive-1.0 демонстрирует, что для расширения возможностей универсальных моделей зрения-языка в таких сложных областях, как автономное вождение, не обязательно перестраивать их ядро. Добавление специализированных, но при этом прозрачных внешних модулей позволяет быстро адаптировать существующие технологии и даёт возможность проверять отдельные компоненты системы. Однако, как отмечают сами разработчики, предстоит ещё усилить согласованность между текстовыми рассуждениями модели и генерируемой траекторией движения.