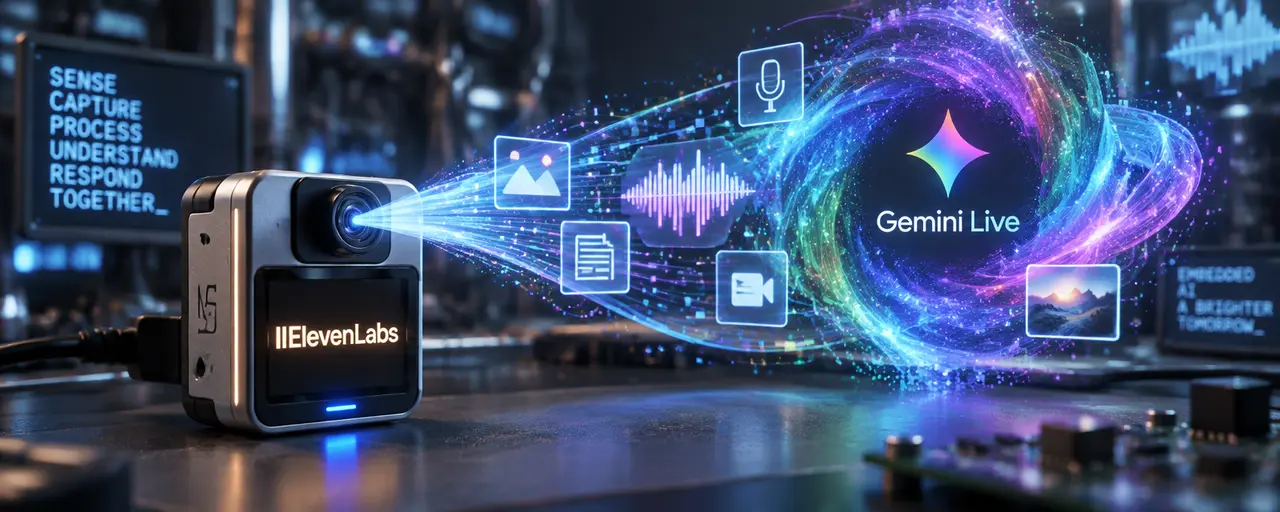
Забудьте о громоздких серверах: теперь для создания полноценного мультимодального AI-агента достаточно крошечного чипа. Глава Developer Experience Торстен Шефф продемонстрировал, как ESP32-S3 с камерой и платформой Gemini Live превращается в автономного помощника, способного видеть и слышать.
Проект Шеффа использует M5Stack AtomS3R-CAM — миниатюрный программируемый контроллер на базе ESP32-S3. Устройство захватывает изображения с камеры GC0308 (0.3 МП) с частотой 0.33 кадра в секунду и речь в реальном времени. Эти данные передаются в Google Gemini Live для обработки, что позволяет создать "живого" мультимодального агента.
В основе агента лежит Google Gemini Live — платформа, которую Google активно продвигает для создания иммерсивных, мультимодальных AI-агентов. Она позволяет обрабатывать и генерировать информацию в различных форматах, включая текст, изображение и звук, в реальном времени.
Разработка таких агентов упрощается благодаря специализированным инструментам, например, Antigravity IDE. Эта среда позиционируется как "agent-first", где разработчик выступает в роли архитектора и оркестратора автономных AI-агентов, а не просто пишет код.
Эта демонстрация показывает, что мультимодальный AI становится доступным для встраиваемых систем, стирая грань между облачными вычислениями и локальными устройствами. Однако пока неясно, насколько эффективно Gemini Live обрабатывает данные с такой низкой частотой кадров и какова задержка ответа в реальных сценариях при работе с бюджетным железом.