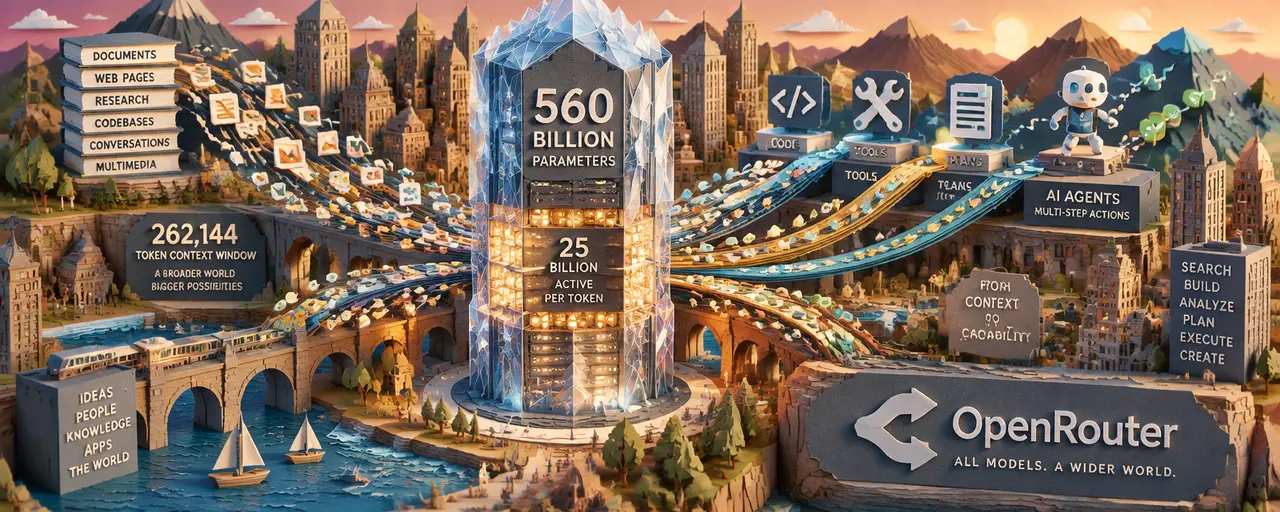
В то время как многие флагманские модели стремятся к миллиону токенов контекста, OpenRouter добавил Ling 3.1 Flash от inclusionAI — специализированную модель с внушительным окном в 262 144 токена, заточенную под агентские рабочие процессы. Для инженеров это означает новые возможности в создании ИИ-агентов, работе с кодом и сложными многошаговыми задачами.
Ling 3.1 Flash позиционируется как гибридная модель рассуждения, оптимизированная для кодинга, использования инструментов, планирования и долгосрочных агентских задач. Она имеет 560 миллиардов общих параметров, из которых 25 миллиардов активны на токен, что указывает на архитектуру Mixture-of-Experts (MoE).
Контекстное окно в 262 144 токена позволяет модели обрабатывать объемы информации за один запрос. Это критично для анализа больших кодовых баз, объемных документов или сложных многошаговых инструкций для ИИ-агентов. Для сравнения, многие модели на рынке предлагают контекст около 1 миллиона токенов, а некоторые, как Llama 4 Scout, доходят до 10 миллионов.
Модель доступна на OpenRouter — платформе, которая агрегирует API различных моделей, предлагая унифицированный доступ и, как правило, конкурентные цены. Стоимость использования Ling 3.1 Flash составляет $0.075 за 1 млн входных токенов и $0.22 за 1 млн выходных токенов.
Интеграция Ling 3.1 Flash на OpenRouter подчеркивает запрос рынка на специализированные, производительные модели с большим контекстом для конкретных инженерных задач, таких как разработка ИИ-агентов. Однако, inclusionAI пока не предоставила публичных бенчмарков, которые бы подтверждали эффективность модели в сравнении с конкурентами при работе с таким объемом контекста.